11月16日,蚂蚁灵波首届具身大模型挑战赛总决赛收官。活动期间,蚂蚁灵波CEO朱兴在交流中表示,全球范围内还没有一家公司真正迎来具身智能的Scaling Law时刻。对于具身智能能否复制大语言模型的规模化跃迁,他保持审慎。
在大语言模型领域,参数和数据同步扩张曾带来可预测的能力提升。朱兴认为,物理世界中的前提并不相同,一条稳定且可规模化复现的数据路径仍未找到。行业还处在攻坚探索阶段,如同幼儿学步,前期难免不稳和受挫,需要理性看待。
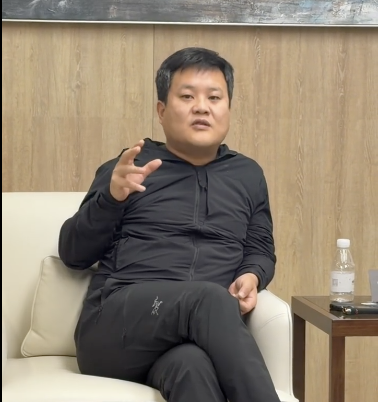
围绕数据,具身智能赛道正在展开军备竞赛。真机数据、第一人称视角数据、UMI通用操作数据、仿真数据和互联网视频都在争取规模化的定义权。朱兴表示,各类数据都有价值,但价值取决于训练阶段,没有一条路线可以通吃。
他进一步解释,越接近预训练,以人为中心的互联网视频和Ego数据更适合获取世界常识;越进入拆垛、上下料、物流分拣等具体任务落地,贴近真实场景与机器人本体的真机数据才更能发挥作用。数据需求的主导权应掌握在基础模型研发团队手中,而不是数据供应商或本体厂商。模型缺少什么数据、需要怎样的分布和多样性,要回到模型训练效果判断。缺少深度理解和质量管控的盲目扩量,是巨大的资源浪费。
蚂蚁灵波首席科学家沈宇军补充说,具身智能涉及的问题很多,灵波更关注数据模态、数据质量,以及如何把数据有效用于模型训练并转化为模型能力提升。
过去一年,具身智能行业的数据采集和供给体系持续优化,底层基础工作稳步推进。工厂、物流场景试点不断铺开,复杂真机操作案例逐步增多。朱兴表示,模型能力没有出现颠覆性质变,但实现了量级层面的提升。
他判断,按照当前节奏,从明年开始,具身智能产业落地将迎来规模化提速。落地过程中沉淀的大量异常场景数据持续回流,会形成类似自动驾驶的数据反哺闭环,推动模型迭代升级。与落地加速同步发生的,是行业格局第一轮收敛。明年之前,具身智能基础模型领域会出现第一波收敛,数据范式、评测基准、技术路线与产业分工逐步定型。
参照大语言模型市场的发展,如今由几家主导,具身赛道也会复刻类似路径。朱兴表示,长期看,中国具身基础模型玩家将收缩至3到5家,蚂蚁灵波希望成为其中之一。不过,具身智能的产业周期会比自动驾驶更长,先收敛一波,再分裂一波,再收敛一波。穿越周期依靠团队、数据理解与训练基础设施三项底层能力。
回看大语言模型市场,赛道完成收敛后,头部企业能够持续留在牌桌上,新参与者很难入场,比拼的正是团队与底层基建实力。蚂蚁灵波正试图以开源和生态方式为收敛进程做准备。挑战赛使用的统一开源预训练模型LingBot-VLA 2.0,以及已适配全球主流机器人开发平台LeRobot的LingBot模型矩阵,指向同一策略:在硬件构型百花齐放的现实下,先把通用具身大脑的开发者底座铺开。
朱兴直言,灵波不相信机器人本体构型会走向大一统。重载作业与轻载分拣、固定工位与移动场景的需求天然不同,强求统一人形反而会推高成本、阻碍规模化。